Den nye forvaltningsloven krever at forvaltningen dokumenterer og publiserer «det rettslige innholdet» i automatiserte saksbehandlingssystemer. Men hva er det? Mitt svar på kjernen i spørsmålet: Beskriv beslutningen, reglene og faktaene, med hjemmel.
I november 2019 sendte vi i Decisive et høringssvar til forslaget om ny forvaltningslov. Jeg var med og skrev det. Der står denne setningen: Den rettslige kravspesifikasjonen bør som et minimum inneholde en beskrivelse av beslutningene, reglene som styrer utfallet av beslutningene, og fakta som er nødvendig for å ta beslutningene.
Seks år senere er loven vedtatt. Ifølge § 13 skal forvaltningsorganet «dokumentere det rettslige innholdet i automatiserte saksbehandlingssystemer». Høsten 2025 ba Justisdepartementet om innspill til en forskrift som skal fylle ut bestemmelsen. Et av spørsmålene fra Nav var: Hva ligger egentlig i «det rettslige innholdet»?
Bestemmelsen har to deler. Innholdet skal dokumenteres, og dokumentasjonen skal offentliggjøres, med mindre særlige hensyn taler mot det. Ifølge proposisjonen er formålet å legge til rette for åpenhet og kontroll med den automatiserte rettsanvendelsen, og å styrke tilliten til at forvaltningen automatiserer riktig.
Publiseringen fortjener et eget innlegg. Her skriver jeg om kjernen i det som skal publiseres: hvordan rettsreglene faktisk anvendes i systemet. Proposisjonen sier selv at plikten «først og fremst» gjelder hvordan rettskildene er operasjonalisert i systemet (s. 93).
Innlegget er skrevet for deg som sitter i forvaltningen med dette problemet på bordet, og for dem som nå skriver forskriften. Jeg tror svaret er enklere enn mange frykter. Men det krever at vi begynner i en annen ende enn vi pleier.
Ingen vet helt hva som skal dokumenteres
Det er ikke bare Nav som lurer. Departementet fikk 60 innspill, og flere av dem peker på det samme problemet:
- Nav spør om det rettslige innholdet bare er reglene som automatiseres, eller også rammereglene og de tekniske valgene rundt dem. Nav frykter at dokumentasjonen blir svært omfattende, og skriver at eldre systemer er krevende å dokumentere.
- Sivilombudet skriver at formuleringen i § 13 «gir begrenset veiledning om hva dokumentasjonen skal inneholde».
- Digitaliseringsdirektoratet erfarer at det «ofte råder usikkerhet på dette feltet».
- Lovavdelingen i Justisdepartementet sier til Advokatbladet at de er usikre på «hvor mye som egner seg som generell regulering».
Forskriften er ennå ikke sendt på høring. Det er altså fortsatt mulig å påvirke hva svaret blir.
To fristelser og én stor bøtte
Når noe skal dokumenteres, er det fristende å ta utgangspunkt i det som allerede finnes. Jeg ser to varianter.
Den første er å dokumentere reglene. Du går gjennom loven paragraf for paragraf og skriver bestemmelsene om til strukturert språk eller pseudokode. Det er langt på vei dette NOU 2019:5 la opp til. Utvalget skriver at «ofte vil kravspesifikasjonen være pseudokode eller ha lignende semiformelt uttrykk», og at dokumentasjonen skal «vise til reglene som de ulike delene av pseudokoden er basert på» (punkt 18.3.3.5, s. 265–266). Utvalget vil også ha dokumentert begrepsdefinisjonene, og det er et godt stykke på vei mot faktaene. Utvalget snakker også om å ta stilling til «alle rettsspørsmålene som er relevante for systemet» (punkt 18.3.3.1, s. 259), men sier ikke at spørsmålene skal beskrives som beslutninger.
Den andre er å dokumentere kildekoden. Digdir mener at koden «gir fasiten», at den bør være åpen, og at språkmodeller kan forklare den.
Begge sporene har noe for seg. Presise regler er nødvendig, og åpen kode er bra. Men ingen av dem forteller hvilket spørsmål systemet svarer på. Du ender opp med en stor bøtte med regler, og ingen vet hva bøtta skal brukes til. En språkmodell kan forklare hva koden gjør. Den kan ikke fortelle hvilket spørsmål koden skulle svare på, hvis ingen har beskrevet det. (Om KI og behovet for deterministiske svar skriver jeg en annen gang.)
Dette er ikke nytt, og problemet er godt dokumentert. I 2010 skrev Åshild Johnsen en masteroppgave i forvaltningsinformatikk om å uttrykke pensjonsregelverk som strukturerte regler med OMG-standarden SBVR. Oppgaven er verdifull. Ved å modellere vokabular og regler presist avdekket hun reelle uklarheter i folketrygdloven, for eksempel hva «minst tre av de siste fem kalenderårene» egentlig betyr.
Oppgaven viser også tydelig hva som skjer når vi bare ser på reglene. Reglene om medlemskap i folketrygden ble til 18 regler som skal prøves i en bestemt rekkefølge, der regel 16 til slutt «avgjør saken». Svaret blir avhengig av rekkefølgen. Johnsen gjorde det informatikere lærer: Et program behandler setninger i rekkefølge. Men jeg har alltid ment at svaret på et rettslig spørsmål skal bli det samme uansett hvilken rekkefølge du vurderer vilkårene i.
Johnsen er selv inne på løsningen. Hun skriver at reglene må være presise både for å avgjøre om en person er medlem og for å beregne lengden av medlemskapet. Det er to beslutninger. Beskriver vi dem, trenger vi ingen regelflyt. Det samme gjelder faktaene: Vokabularet hennes beskriver begrepene grundig, men ikke hvor dataene skal hentes fra.
Tre beskrivelser: beslutningen, reglene og faktaene
En beslutning tas i tre steg: Du klarlegger regelen, du klarlegger faktum, og så anvender du regelen på faktum. Det kan enhver jurist. Når et system skal ta beslutningen, må alt beskrives. I en regelanalyse etter Decisivemetoden blir det tre artefakter som henger sammen: en beskrivelse av beslutningen, en beskrivelse av reglene og en faktamodell.
Jeg viser dem med et eksempel fra IMDi. IMDi gir tilskudd til kommuner som bosetter og integrerer flyktninger, og har automatisert behandlingen av tilskuddene i regelmotoren SMARTS. Allerede før automatiseringen var IMDi opptatt av hvilke krav som gjelder til dokumentasjon når en tilskuddsordning automatiseres.
1. Beslutningen: en SVUS
Vi beskriver beslutningen i en SVUS: spørsmål, vurderinger, utfall og særtilfeller. På engelsk heter det en Q-COE, der C står for consideration. Jurister forbinder gjerne «vurdering» med skjønn, men her betyr ordet noe annet. En vurdering er informasjon vi trenger for å svare på spørsmålet, beskrevet som et faktum som enten er sant eller usant. SVUSen viser hvilket spørsmål systemet svarer på, hvilke fakta som må vurderes, og hvilke svar det kan gi.
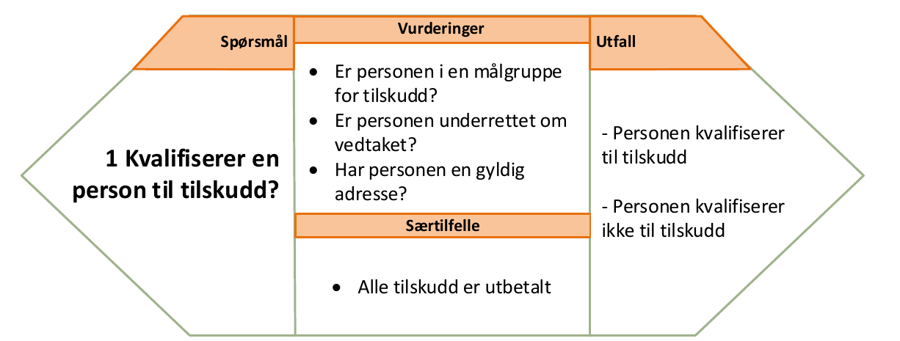
Hver vurdering kan selv være en ny beslutning med sin egen SVUS. «Er personen i en målgruppe for tilskudd?» er et eget spørsmål med egne regler. Slik vokser beslutningsstrukturen, men den vokser med knagger, ikke som en bøtte.
2. Reglene: en beslutningstabell
Først når vi kjenner spørsmålet og vurderingene, vet vi hvilke regler som er relevante. For denne beslutningen beskrev vi reglene i en beslutningstabell:
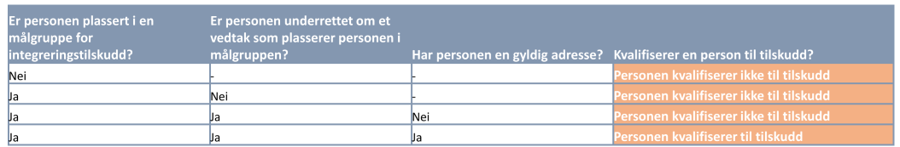
Tabellen leses vannrett, og svaret står i kolonnen lengst til høyre. Legg merke til at rekkefølgen ikke betyr noe: Hver rad gir samme svar uansett hvilken vurdering du tar først. Den samme regelen kan også skrives i RuleSpeak: En person skal anses som kvalifisert til tilskudd gitt at alle følgende er sant: personen er i en målgruppe for tilskudd, personen er underrettet om vedtaket, og personen har en gyldig adresse.
Hver vurdering har sin hjemmel. Målgruppene for tilskuddet er beskrevet i et rundskriv fra departementet «Regelverk for Integreringstilskudd, eldretilskudd og barnehagetilskudd – kap. 671 post 60.» Personen havner i en målgruppe gjennom et vedtak fra UDI som danner grunnlag for varig opphold, for eksempel som flyktning etter utlendingsloven § 28. I regelanalysen peker hver regel tilbake til hjemmelen den bygger på. Det er koblingen mellom regel og hjemmel som gjør beskrivelsen til en beskrivelse av det rettslige innholdet, og ikke bare av logikken.
3. Faktaene: en faktamodell
Reglene bruker begreper som målgruppe, vedtak, underretting og adresse. Faktamodellen viser hvordan begrepene henger sammen. Vi lager den som en konseptmodell etter OMGs standard SBVR.
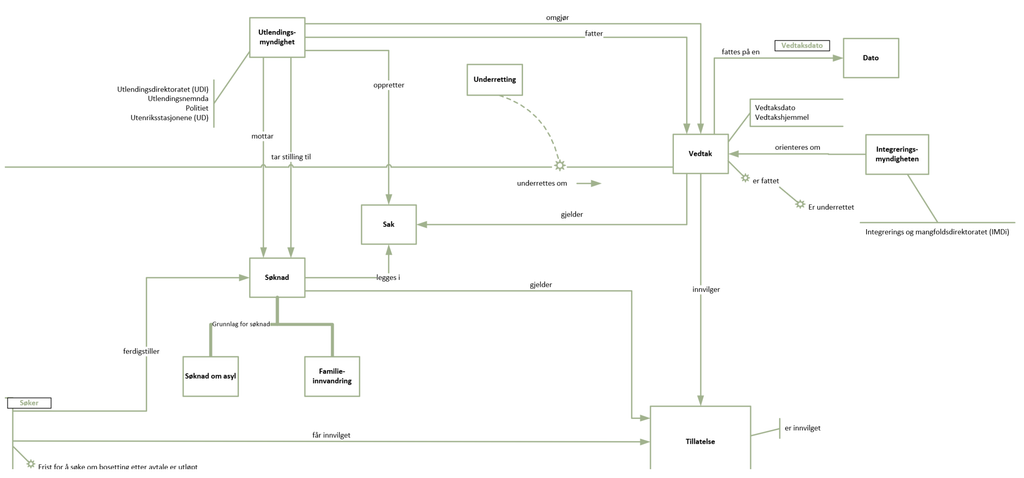
Her ser vi for eksempel at det er utlendingsmyndigheten som fatter vedtaket, og at personen skal være underrettet om det. Hvert faktum må så kobles til data. Jeg pleier å si at fakta er det du håper du har data på. Ta «Har personen en gyldig adresse?». I IMDi bygger løsningen på folkeregistrert adresse, og dataene hentes fra Folkeregisteret.
I andre løsninger kan en person ha både en internt registrert og en folkeregistrert adresse, for eksempel etter flytting fra et asylmottak. Da trengs det regler for hva som gjelder når de to avviker, og også de reglene hører til det rettslige innholdet. Først når faktaene er beskrevet og koblet til data, ser du hvor du har det du trenger, og hvor noe må avklares.
Tre nivåer i dokumentasjonen
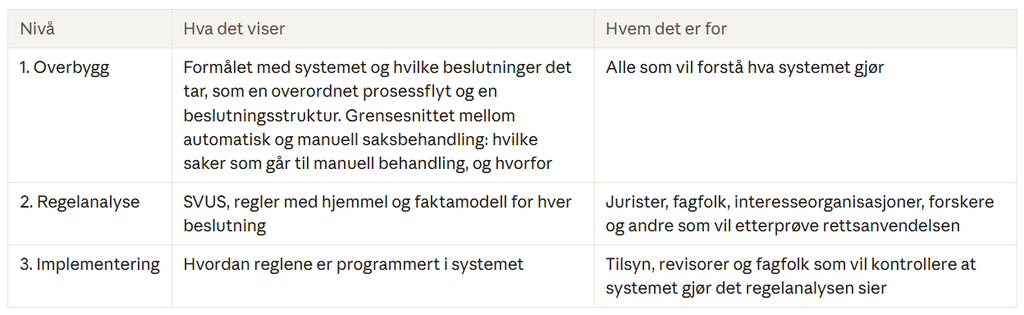
Regelanalysen er kjernen, men den står ikke alene. Jeg ser for meg dokumentasjonen i tre nivåer:
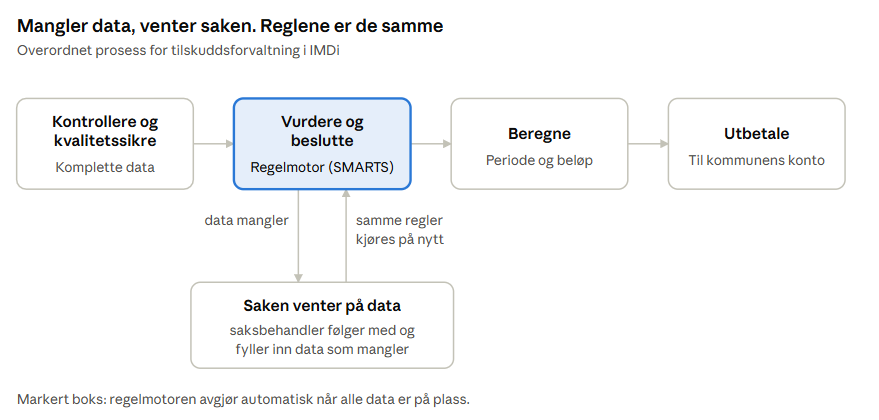
Overbygget er også stedet for å forklare grensesnittet mellom automatisk og manuell saksbehandling. Hvilke saker avgjør systemet selv, og hvilke sendes til en saksbehandler? Når automatiseringsgraden er under 100 prosent, er grensesnittet helt sentralt. Det viser hvilken del av rettsanvendelsen systemet står for, og hvilken del et menneske står for. Skal publiseringen gi åpenhet og kontroll med den automatiserte rettsanvendelsen, må leseren vite hvor den begynner og slutter. I mange systemer er også det regelstyrt, for eksempel når vilkårene krever skjønn. Tilskudd i IMDi er litt spesielt. Her skal systemet få alle data det trenger, så når en sak ikke kan avgjøres, er det fordi noe mangler. Løsningen venter da med avgjørelsen til dataene er på plass. Saksbehandlerne følger med på saker som blir liggende, og fyller selv inn data som mangler. Deretter går saken videre med de samme reglene.
En overordnet prosessflyt viser hvor beslutningene tas, og hvor et menneske må inn i en ellers automatisk behandling. Prosessen under bygger på IMDis overordnede prosess for tilskuddsforvaltning.
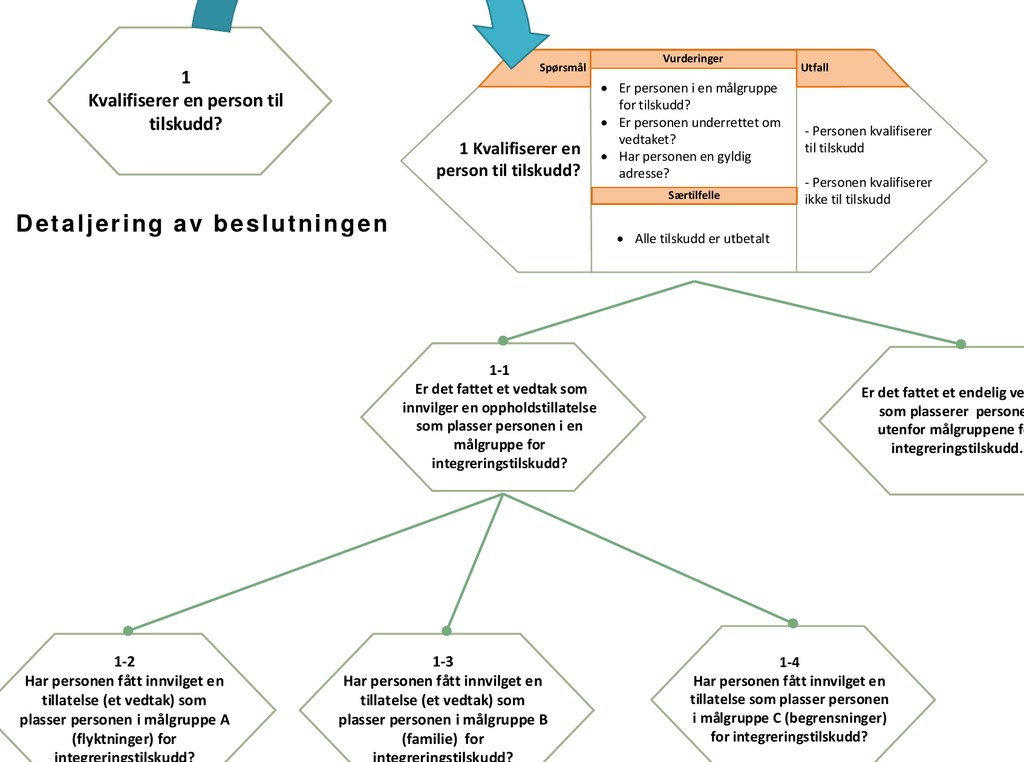
På nivå 1 kan IMDi vise beslutningsstrukturen: hovedbeslutningen og delbeslutningene den bygger på.
Nivå 2 er det jeg har vist ovenfor. Nivå 3 er enkelt når reglene ligger i en regelmotor. IMDi implementerte reglene i SMARTS og endte med tre regeltjenester og 198 regler. SMARTS er selvdokumenterende, så IMDi kan ta ut en rapport som viser hvordan reglene fra regelanalysen er implementert. Under ser du delbeslutning 1-2, «Er personen i målgruppe A?», slik den ser ut i SMARTS. Legg merke til at hjemlene i utlendingsloven og utlendingsforskriften står i reglene.
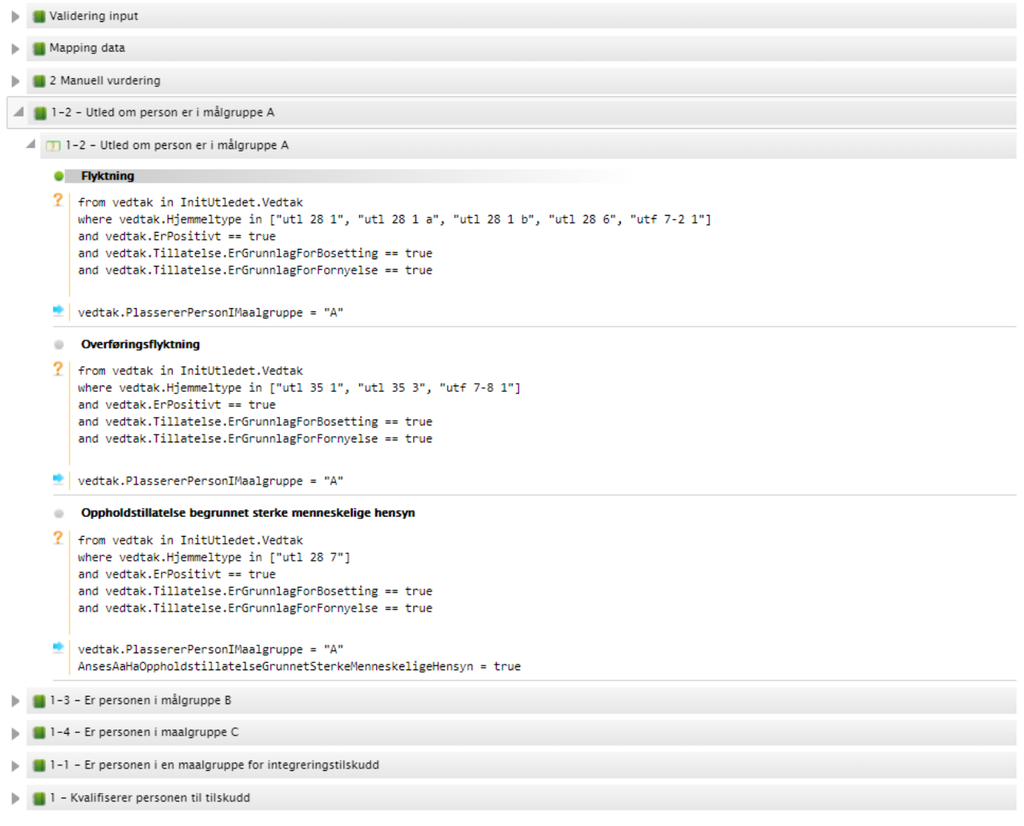
Med beslutningene som knagg henger de tre nivåene sammen. Nummeret 1-2 er det samme i beslutningsstrukturen, i regelanalysen og i systemet. Uten beslutningene ville de 198 reglene vært en bøtte. Med beslutningene er de et kart.
Hvorfor beslutningen løser problemet
Nav frykter at dokumentasjonen blir uendelig. Det blir den hvis du begynner med reglene, for regelverket henger sammen med alt. Begynner du med beslutningen, får du en naturlig avgrensning: Det rettslige innholdet er det som trengs for å svare på spørsmålet. Verken mer eller mindre.
Beslutningen er også en naturlig enhet for versjonering. Når en regel endres, ser du hvilke beslutninger som berøres, og oppdaterer dokumentasjonen for dem.
For eldre systemer gir beslutningen et sted å starte. Du trenger ikke dokumentere all koden. Begynn med å liste opp beslutningene systemet tar.
Jeg er ikke alene om dette synet. Brønnøysundregistrene foreslår i sitt innspill at dokumentasjonen skal vise beslutningene, rettsfaktaene og faktakildene. Dag Wiese Schartum foreslår i sitt innspill at den skal vise opplysningstypene, kildene til dem og reglene som er utledet av rettskildene. Det er et godt stykke på vei. Det som mangler, er beslutningen som binder det sammen.
Fem spørsmål før forskriften kommer
Du trenger ikke vente på forskriften for å komme i gang. Still disse spørsmålene for hvert automatiserte system dere har:
- Hvilke beslutninger tar systemet, formulert som spørsmål?
- Hvilke svar kan hver beslutning gi?
- Hvilke regler styrer svaret, og hvor står hjemmelen?
- Hvilke fakta trenger reglene, og hvor kommer dataene fra?
- Hvor har dere fakta, men ikke data?
Kan du svare på disse fem, har du langt på vei dokumentert det rettslige innholdet.
Til dere som skriver forskriften: Still krav om at dokumentasjonen viser beslutningene systemet tar, reglene med hjemmel og faktaene reglene bygger på. Da får forvaltningen et svar på hva «det rettslige innholdet» er, og leserne får noe de kan etterprøve.
Vi skrev det i 2019, og jeg mener det fortsatt: Begynn med beslutningen. Lurer du på hvordan dere kan dokumentere deres systemer, er det bare å ta kontakt.